
RiC E: terug naar het 'sandbox'-idee
Aan het einde van de ontwikkeling van mijn RiC Editor, een wat uit de hand gelopen experiment waarover ik eerder al eens schreefZie: https://cannedit.org/blog/een-best-wel-ingewikkeld-onderwerp-in-een-tool-ric-e., besloot ik om de publicatie van de source code uit te stellen. Niet omdat de code nog niet werkte, integendeel: er stond al een eerste versie online die EAD en EAC-CPF XML bestanden kon importeren, de basis informatie daarvan kon omzetten naar een eenvoudig relationeel RiC-model en vervolgens weer als JSON-LD en RDF Turtle kon exporteren, maar omdat ik wist dat er iets aan zat te komen. De Technical Subcommittee on Encoded Archival Standards (TS-EAS) werkte aan nieuwe versies van de internationale archiefstandaarden en inmiddels zijn die ook daadwerkelijk verschenen: EAD 4.0, EAC-CPF 3.0 en EAC-F 1.0, nu alle drie samengebracht in de vernieuwde EAS-suiteZie: https://saa-sdt.github.io/EAS-Best-Practices/docs/eas-suite.. Dus ik dacht: misschien is het verstandiger om nog even te wachten, want waarom zou ik een nieuwe tool publiceren die bij verschijning eigenlijk al meteen achterloopt? Dat leek aanvankelijk een goed idee, maar na wat onderzoek ben ik daar toch anders over gaan denken.
 |
 |
Van EAD naar RiC
Wie mijn eerdere blogpost over dit onderwerp heeft gelezen, weet dat de RiC Editor tot stand is gekomen uit een oude fascinatie. Zo'n twintig jaar geleden was ik betrokken bij de ontwikkeling van proMEAD, een EAD Editor waarmee archivarissen eenvoudig, via formulieren, een archiefinventaris konden maken, om die vervolgens als EAD/XML te exporteren voor gebruik elders. Dat project liep uiteindelijk vast, maar het concept (+ code) bleef bij mij hangen. Na mijn pensionering kreeg ik weer tijd om dit op te pakken, alleen was EAD inmiddels niet meer het interessante eindpunt. Records in Contexts (RiC)Zie: https://www.ica.org/resource/isadg-general-international-standard-archival-description-second-edition/. was verschenen en wel op basis van het fundamentele idee: waarom zouden we informatie over archieven blijven aanbieden als een verzameling hiërarchisch ingerichte bestanden, terwijl die in werkelijkheid een netwerk van Records, Actoren, Activiteiten, Plaatsen, Concepten en de relaties daartussen kan bieden? Daarom begon ik niet meer aan een nieuwe EAD Editor, maar aan een RiC Editor, onder andere ook als uitvloeisel van mijn oudere blogpostZie: https://cannedit.org/blog/van-bestand-naar-netwerk-de-belofte-van-records-in-contexts-ric. over de noodzaak het gebruik van deze gloednieuwe standaard een boost te geven via het beschikbaar stellen van goede en gebruiksvriendelijke tools voor de implementatie ervan. De huidige versie van de RiC Editor ondersteunt inmiddels - naast het handmatig invoeren van gegevens voor alle bovengenoemde RiC entiteiten - het importeren van bestaande EAD 2002 (inclusief de apeEAD variant), EAD3, EAC-CPF 2010 (inclusief de apeEAC-CPF variant) en EAC-CPF 2.0 XML bestanden, en daarom rees bij mij de vraag: moet ik daar nu ook EAD4, EAC-CPF3 en EAC-F1 aan toevoegen?
Een 'uitstapje' naar de nieuwe standaarden
Vooral bij EAD4 werd duidelijk dat het antwoord niet zo eenvoudig is. EAD4 is geen kleine technische update van EAD3. De nieuwe versie is nadrukkelijk ontworpen voor een 'digital-first' wereld, met meer aandacht voor Linked Data, interoperabiliteit met EAC-CPF3 en EAC-F1 en aansluiting op externe schema's. Tegelijkertijd zijn een aantal oude, meer op 'print' gerichte constructies verwijderd of vereenvoudigd. Ook de structuur van de onderdelen van een archiefbeschrijving is veranderd. Dat klinkt op papier allemaal heel logisch, maar voor een aanpassing van de RiC Editor 'importer' betekent het nogal wat.
Bij mijn experimenten met EAD4 bleek bijvoorbeeld dat het oude '<did>'-denken niet één-op-één kan worden overgenomen. EAD4 introduceert daarvoor in de plaats het element '<identificationData>'. Daarnaast heeft het een nadrukkelijkere scheiding tussen beschrijvingen en informatie over representaties en bevat het daarvoor ook nieuwe structuren. Bijvoorbeeld '<formAvailable>' maakt met <physicalDescription>' en '<physicalOrTechnicalRequirements>' duidelijk dat informatie over representaties die in oudere EAD versies nog gemakkelijk als een stukje tekst werd behandeld, nu veel gestructureerder kan worden vastgelegd en juist dat is voor RiC interessant. Een fysieke of digitale representatie is in RiC immers niet hetzelfde als het record dat die representatie beschrijft. Voor mijn eigen datamodel was ik al tot de conclusie gekomen dat een aparte Representatie (lees: Instantiation) entiteit eigenlijk de meest logische oplossing is, maar daarmee wordt het aanpassen van de 'importer' voor EAD4 ook meteen een stuk ingewikkelder. Je kunt de EAD4 ondersteuning dus niet eenvoudig behandelen als: EAD3-importer kopiëren, hier en daar wat aanpassen en klaar. Dat zou misschien voor een demo kunnen werken, maar het zou geen recht doen aan de informatie die EAD4 juist probeert exacter te modelleren.
Daarnaast had ik ook een praktisch probleem. Als je software schrijft die XML moet importeren, heb je XML bestanden nodig om mee te testen, het liefst heel veel XML bestanden. Dus niet alleen wat minimale voorbeelden uit een Tag Library, maar echte, grote, rommelige bestanden uit de praktijk. Bestanden waarin allerlei combinaties van elementen voorkomen, waarin lokale keuzes zijn gemaakt en waarin je tegen precies die uitzonderingen aanloopt die je niet had voorzien. Bij EAD 2002 heb je daar geen gebrek aan en ook voor EAD3 is inmiddels behoorlijk wat materiaal beschikbaar. Maar voor EAD4 is die praktijkvoorraad er natuurlijk nog nauwelijks. Tijdens mijn zoektocht naar EAD4 testbestanden kwam ik uiteindelijk wel een aantal interessante officiële testbestanden van Archives de France tegen, maar die waren vooral bedoeld om bepaalde onderdelen van EAD4 te testen en waren vaak handmatig vanuit EAD2002 aangepast. Dat is weliswaar nuttig materiaal, maar het is iets anders dan een flinke verzameling bestanden uit een productie omgeving, waarmee je kunt ontdekken wat er 'in het echt' allemaal gebeurt en waarmee je kunt zien waar het in je tool mis kan gaan. Hetzelfde geldt in nog sterkere mate voor EAC-CPF3 en EAC-F1. Op basis van die Tag Libraries kan ik prima een aantal testbestanden maken waarmee ik kan kijken of mijn XML-parser bepaalde elementen kan verwerken, maar daarmee kan ik nog niet echt zeggen: "de RiC Editor ondersteunt EAC-CPF3 en EAC-F1". Daarvoor zou ik dus graag eerst willen zien hoe archiefinstellingen die nieuwe standaarden daadwerkelijk gaan implementeren en dat is nog wel een 'dingetje'.
Een nieuwe standaard wordt niet meteen nieuwe praktijk
Natuurlijk duurt het even voordat een compleet nieuwe standaard zoals RiC volop in de praktijk wordt toegepast, maar dat geldt helaas ook voor nieuwe versies van oudere, al lang bestaande en geïmplementeerde standaarden. De TS-EAS heeft in 2026 opnieuw onderzoek gedaan naar het gebruik van de verschillende versies van de Encoded Archival StandardsZie: https://saadescription.wordpress.com/2026/06/09/standards-in-practice-findings-from-a-community-survey-on-encoded-archival-standards/. en de resultaten zijn interessant. Van de archiefinstellingen die aangaven EAD te gebruiken, werkt 70% nog met EAD 2002 en slechts 23,7% met de opvolger daarvan: EAD3, gelanceerd in 2015. Dat betekent natuurlijk niet dat EAD3 nog nauwelijks wordt gebruikt. Integendeel: het onderzoek laat ook zien dat het gebruik van EAD3 is toegenomen sinds 2018, toen ik - samen met Kathy Wisser - eenzelfde onderzoek deed namens de TS-EASZie: https://loc.gov/ead/EAD3_Implementation_Survey_Results_and_Discussion_20190320.pdf.. Maar dit toont wel duidelijk aan dat de introductie van een nieuwe standaard vandaag, niet automatisch betekent dat de vorige standaard morgen al uit de praktijk is verdwenen. Er moeten systemen worden aangepast, conversies gemaakt, oude bestanden gemigreerd, workflows aangepast en medewerkers opgeleid. En vooral: er moet een reden zijn om dat allemaal te doen en zo'n proces kan behoorlijk lang duren. Met de introductie van EAD4 is EAD 2002 officieel 'deprecated'Zie: https://loc.gov/ead/. en wordt het dus door de TS-EAS niet meer ondersteund, maar uit het TS-EAS 2026 onderzoek blijkt dat het nog steeds door veel archiefinstellingen wordt gebruikt. Een belangrijk gegeven voor een klein experimenteel project als de RiC Editor.
Ik geef toe, mijn eerste reactie na het TS-EAS bericht over de nieuwe standaarden was: natuurlijk moet de RiC Editor die ondersteunen. Maar hoe langer ik ermee bezig was, hoe minder vanzelfsprekend dat werd. Voor EAD4 bijvoorbeeld zou een behoorlijk deel ervan 'op de schop' moeten. Niet alleen vanwege de gewijzigde XML-structuur, maar ook omdat EAD4 informatie kan bevatten die ik in mijn huidige RiC-model nog helemaal niet goed kan representeren.
Bij EAC-CPF3 ligt het iets genuanceerder. Deze nieuwe versie sluit op verschillende punten juist heel aardig aan bij wat ik in de RiC Editor al heb gebouwd, op basis van de vorige EAC-CPF versies. Daarmee is EAC-CPF3 technisch waarschijnlijk gemakkelijker aan mijn bestaande model te koppelen dan EAD4. Ook de aandacht voor URI's, vocabulary sources en relaties sluit goed aan bij waar ik met de RiC Editor naartoe wil. Maar ook voor EAC-CPF3 geldt: ik heb er op dit moment gewoon te weinig bestanden uit de praktijk voor. Ik zou mijn bestaande 'importer' kunnen aanpassen zodat die, op basis van de officiële documentatie en een handvol testbestanden, keurig EAC-CPF3 XML inleest, maar wat heb ik dan bewezen? Dat ik de Tag Library kan inlezen? Dat is leuk voor mij, maar niet noodzakelijkerwijs nuttig voor iemand die met de RiC Editor daadwerkelijk aan de slag wil om de mogelijkheden van RiC te verkennen.
Eigenlijk is de eerste versie van EAC-F voor RiC nog wel de meest interessante van de drie nieuwe standaarden. Functies vormen immers een belangrijk onderdeel van RiC. Daarom ondersteun ik in de RiC Editor al 'Concepten', waaronder 'Functies', 'Mandaten' en 'Onderwerpen', en daarnaast een aparte entiteit 'Activiteiten'. EAC-F probeert het soort informatie te beschrijven dat in traditionele archiefbeschrijvingen vaak nogal moeilijk zichtbaar wordt: waarom bestaan bepaalde archiefstukken eigenlijk, welke functie, activiteit of verantwoordelijkheid ligt eraan ten grondslag? Dat sluit prachtig aan bij het idee achter RiC, maar juist daarom zou ik eerst nog eens goed willen nadenken over de semantiek. Is een EAC-F-functie in de RiC Editor een 'Concept' van het type 'Functie' of Is het een 'Activiteit'? Of kan het afhankelijk van de context allebei zijn? Dat zijn voor mij interessantere vragen dan alleen: kan mijn RiC Editor EAC-F verwerken? Misschien moet ik EAC-F daarom juist eerst goed begrijpen vanuit RiC, in plaats van zo snel mogelijk een EAF-importer proberen te bouwen.
Terug naar de 'sandbox'
Gaandeweg drong zich bij mij de vraag op: moet ik wel tijd steken in het zo goed mogelijk ondersteunen van alle nieuwe versies van de bestaande archiefstandaarden, wetende dat die op korte termijn zeker nog niet in gebruik zullen worden genomen, terwijl het eigenlijke doel van mijn RiC Editor juist is te onderzoeken hoe we bestaande archiefinformatie naar RiC zouden kunnen omzetten? Dit leidde vervolgens tot de vraag: moeten we wel alle tussenstappen volgen om uiteindelijk bij RiC uit te komen? Mijn antwoord daarop is inmiddels: nee, en een tool zoals de RiC Editor kan juist op dat punt nuttig worden: niet wachten totdat de hele archiefwereld netjes is overgestapt naar de nieuwste XML-standaarden, maar kijken naar hoe we van de wereld van nu naar de wereld van RiC zouden kunnen komen.
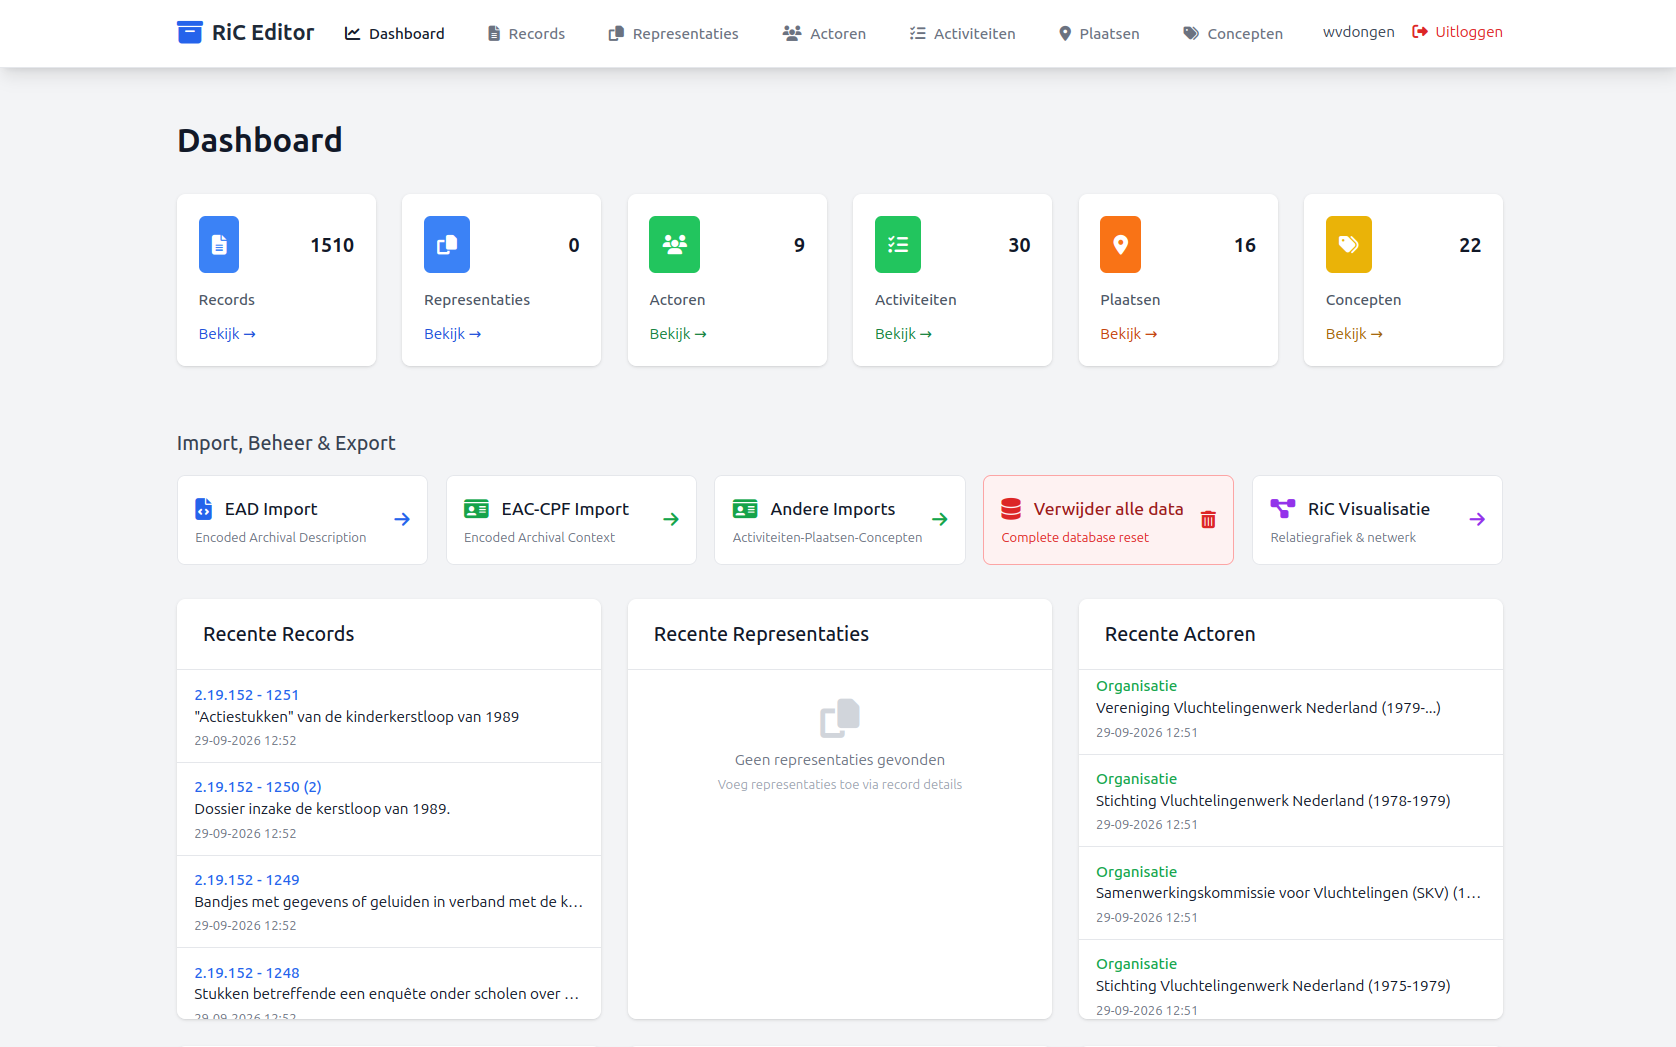
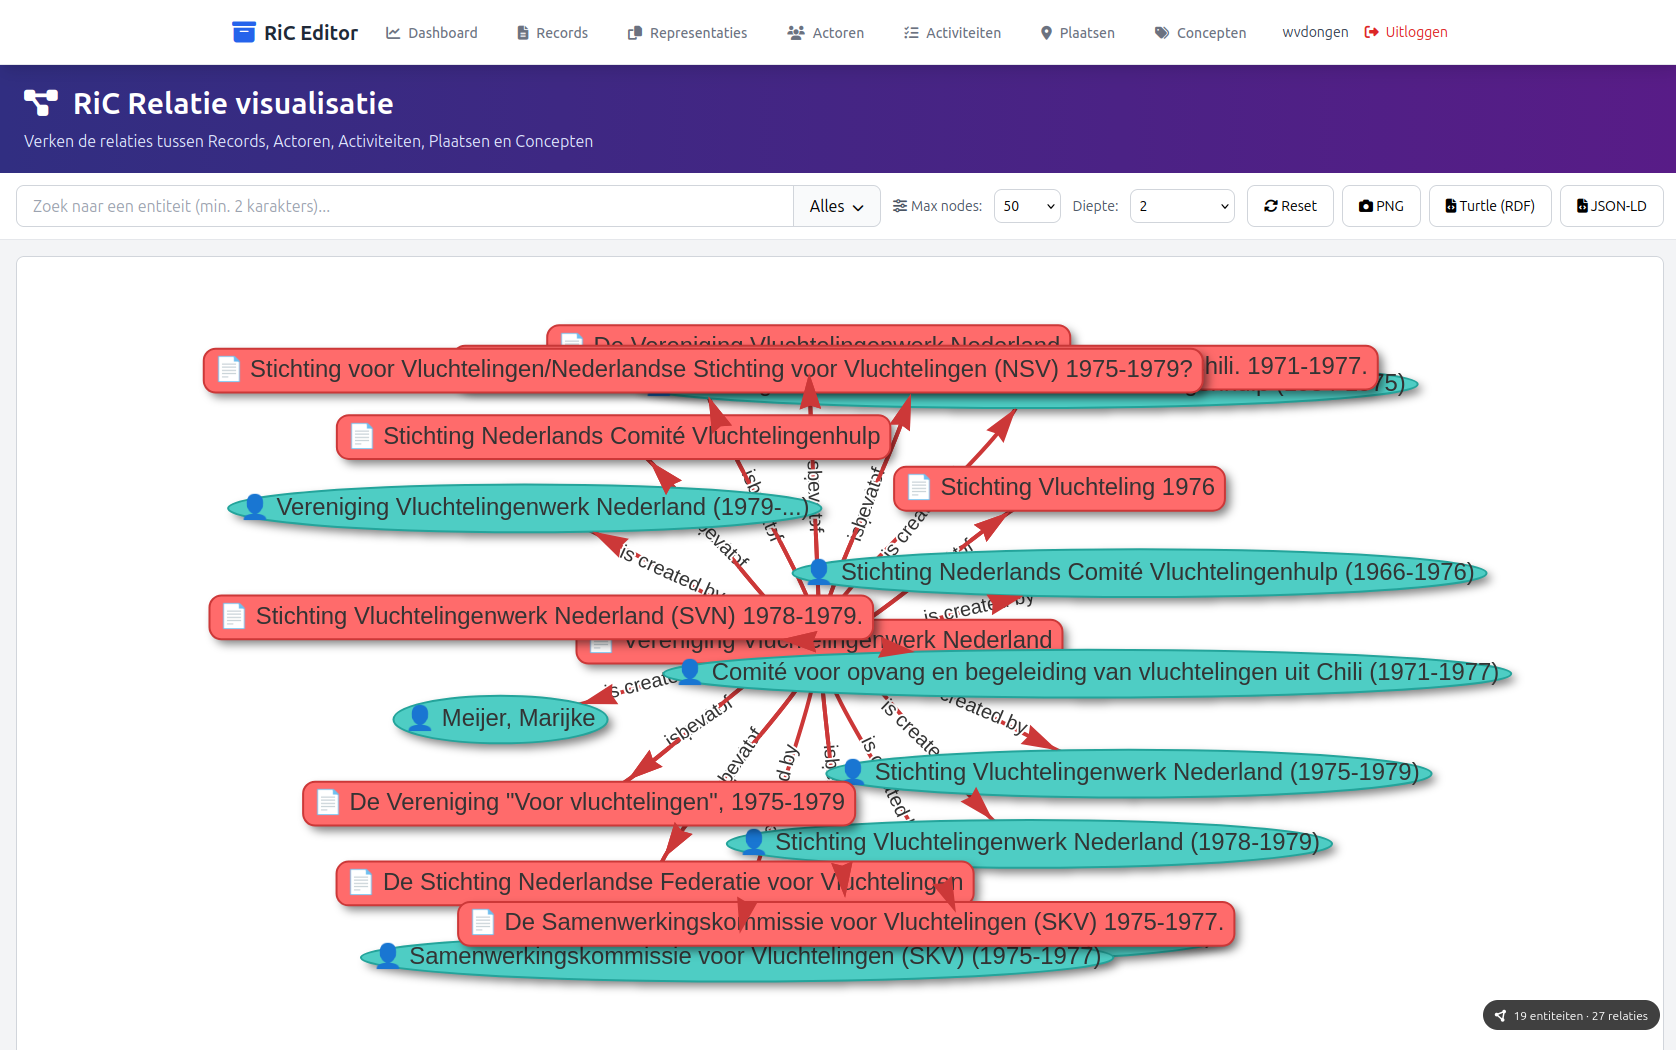
De RiC Editor is ook nooit bedoeld als een kant-en-klaar collectie management systeem waar je een complete dataset naar toe kunt migreren vanuit een oude situatie. Het is vooral een 'sandbox'Inclusief een 'Verwijder alle data'-knop om in één keer al je experimenten uit de onderliggende database te verwijderen zodat je weer een heel nieuw experiment kunt starten., een tool om met RiC te 'spelen', om eens te ervaren: hoe verbind je Records met Actoren, hoe leg je relaties met Activiteiten, Plaatsen en Concepten, wat gebeurt er als je informatie uit bestaande archiefbeschrijvingen op die manier probeert te modelleren, welke informatie verdwijnt daarbij, welke informatie wordt dan juist zichtbaar en welke problemen kom je tegen wanneer je bestaande archiefbeschrijvingen probeert te 'vertalen' naar het gedachtegoed van RiC?
Daarom is nu mijn korte uitstapje naar EAD4, EAC-CPF3 en EAC-F1 voorlopig beëindigd. Maar begrijp me goed: de nieuwe archiefstandaarden zijn interessante en belangrijke ontwikkelingen en ik zal ze zeker blijven volgen. Voorlopig ga ik ze echter niet opnemen in de RiC Editor en eigenlijk geldt hetzelfde voor ondersteuning daarin voor de vele varianten en lokale 'dialecten' van de oudere archiefstandaarden die in de praktijk in omloop zijn.
Eerst maar eens een stabiele versie
Het uitstel van de publicatie van de source code heeft me dus uiteindelijk wel iets opgeleverd. Ik weet nu beter wat ik met de RiC Editor wil en vooral ook wat ik er juist niet mee wil. Daarom ga ik me nu weer volledig richten op de huidige versie zoals ik die even had achtergelaten. Ik heb er nog wat verbeteringen voor in mijn hoofd en ik heb intussen ook nog wat bugs gevonden die ik nog wil oplossen. Het doel is om binnenkort een eerste stabiele versie van de source code te publiceren. Dat wordt dus geen versie waarin alles perfect is en waarin iedere denkbare EAD en EAC-CPF variant wordt ondersteund. Het wordt vooral een eerste versie waarvan ik kan zeggen: hiermee kun je RiC zelf uitproberen, bekijken hoe het werkt. Hoewel de source code dus nog even op zich laat wachten, staat de huidige versie van de RiC Editor inmiddels wel gewoon online op mijn shared hosting account. Wil je er alvast eens mee 'spelen'? Of vind je het interessant om te helpen met testen en bugfixen, dan hoor ik dat graag. Stuur me in dat geval even een berichtje. Misschien levert zo'n extra paar ogen nou net die informatie op die ik nodig heb om de eerste stabiele versie van de RiC Editor sneller de wereld in te brengen.